- Algeria
- Bahamas
- Bahrain
- Belarus
- Belgium
- Belize
- Benin
- Bermuda
- Bhutan
- Bolivia
- Bonaire, Sint Eustatius, and Saba
- Botswana
- Bouvet Island
- Brazil
- British Indian Ocean Territory
- British Virgin Islands
- Brunei
- Bulgaria
- Burkina Faso
- Burundi
- Cambodia
- Cameroon
- Canada
- Cape Verde
- Cayman Islands
- Central African Republic
- Chad
- Chile
- China
- Christmas Island
- Cocos [Keeling] Islands
- Colombia
- Comoros
- Cook Islands
- Costa Rica
- Croatia
- Cuba
- Curaçao
- Cyprus
- Czech Republic
- Congo - Kinshasa
- Denmark
- Djibouti
- Dominica
- Dominican Republic
- Timor-Leste
- Ecuador
- Egypt
- El Salvador
- Equatorial Guinea
- Eritrea
- Estonia
- Ethiopia
- Falkland Islands
- Faroe Islands
- Fiji
- Finland
- France
- French Guiana
- French Polynesia
- French Southern Territories
- Gabon
- Gambia
- Georgia
- Germany
- Ghana
- Gibraltar
- Greece
- Greenland
- Grenada
- Guadeloupe
- Guam
- Guatemala
- Guernsey
- Guinea
- Guinea-Bissau
- Guyana
- Haiti
- Heard Island and McDonald Islands
- Honduras
- Hong Kong SAR China
- Hungary
- Iceland
- India
- Indonesia
- Iran
- Iraq
- Ireland
- Isle of Man
- Israel
- Italy
- Côte d’Ivoire
- Jamaica
- Japan
- Jersey
- Jordan
- Kazakhstan
- Kenya
- Kiribati
- Kosovo
- Kuwait
- Kyrgyzstan
- Laos
- Latvia
- Lebanon
- Lesotho
- Liberia
- Libya
- Liechtenstein
- Lithuania
- Luxembourg
- Macau SAR China
- Macedonia
- Madagascar
- Malawi
- Malaysia
- Maldives
- Mali
- Malta
- Marshall Islands
- Martinique
- Mauritania
- Mauritius
- Mayotte
- Mexico
- Micronesia
- Moldova
- Monaco
- Mongolia
- Montenegro
- Montserrat
- Morocco
- Mozambique
- Myanmar [Burma]
- Namibia
- Nauru
- Nepal
- Netherlands
- New Caledonia
- New Zealand
- Nicaragua
- Niger
- Nigeria
- Niue
- Norfolk Island
- North Korea
- Northern Mariana Islands
- Norway
- Oman
- Pakistan
- Palau
- Palestinian Territories
- Panama
- Papua New Guinea
- Paraguay
- Peru
- Philippines
- Pitcairn Islands
- Poland
- Portugal
- Puerto Rico
- Qatar
- Congo - Brazzaville
- Réunion
- Romania
- Russia
- Rwanda
- Saint Barthélemy
- Saint Helena
- Saint Kitts and Nevis
- Saint Lucia
- Saint Martin
- Saint Pierre and Miquelon
- Saint Vincent and the Grenadines
- Samoa
- San Marino
- São Tomé and Príncipe
- Saudi Arabia
- Senegal
- Serbia
- Serbia and Montenegro
- Seychelles
- Sierra Leone
- Singapore
- Sint Maarten
- Slovakia
- Slovenia
- Solomon Islands
- Somalia
- South Africa
- South Georgia and the South Sandwich Islands
- South Korea
- South Sudan
- Spain
- Sri Lanka
- Sudan
- Suriname
- Svalbard and Jan Mayen
- Swaziland
- Sweden
- Switzerland
- Syria
- Taiwan
- Tajikistan
- Tanzania
- Thailand
- Togo
- Tokelau
- Tonga
- Trinidad and Tobago
- Tunisia
- Turkey
- Turkmenistan
- Turks and Caicos Islands
- Tuvalu
- U.S. Virgin Islands
- Uganda
- Ukraine
- United Kingdom
- United States
- U.S. Minor Outlying Islands
- Uruguay
- Uzbekistan
- Vanuatu
- Vatican City
- Venezuela
- Vietnam
- Wallis and Futuna
- Western Sahara
- Yemen
- Zambia
- Zimbabwe
 by Ts Hasnan
- 03, Nov 2026
llm-d 1.0 Tiba: Mengurus Trafik AI dan Naik Taraf Pelayan dengan Lebih Teratur
Apabila pembantu AI digunakan serentak oleh manusia dan proses automatik, cabarannya melangkaui kemampuan model menjawab soalan. Pasukan IT juga perlu menentukan permintaan yang didahulukan, mengurus kapasiti dan memastikan penyelenggaraan berjalan lancar. Keluaran llm-d 1.0 pada 20 Oktober 2026 memberi tumpuan kepada kerja operasi ini.
Pengumuman projek melalui IBM dan nota keluaran rasminya mengetengahkan kawalan perkongsian sumber, penghalaan serta penyelarasan naik taraf. Bagi pembaca IT Jobs Malaysia, perkembangan ini membuka sudut pembelajaran tentang bagaimana aplikasi AI dikendalikan selepas demonstrasi awal berjaya.
Daripada model kepada perkhidmatan yang boleh dikendalikan
Menurut IBM Research, llm-d ialah rangka kerja inferens teragih berasaskan Kubernetes yang berfungsi bersama enjin seperti vLLM dan SGLang. Inferens merujuk kepada penggunaan model untuk menghasilkan jawapan. llm-d menambah lapisan penghalaan dan operasi supaya beberapa pelayan model boleh bekerjasama sebagai satu perkhidmatan.
IBM menyifatkan versi 1.0 sebagai langkah menuju kematangan operasi selepas pemasangan, termasuk ketika permintaan berubah dan pengguna bersaing mendapatkan sumber. Artikel teknikalnya turut menjelaskan bahawa teknik seperti penggunaan semula cache dan pemisahan pemprosesan arahan daripada penjanaan jawapan sudah wujud sebelum versi ini. Perkembangan baharunya ialah penyepaduan dan kawalan operasi yang lebih matang.
Sumber: llm-d 1.0 hardens open-source AI inference for day 2 production operations.
Mengawal persaingan antara permintaan
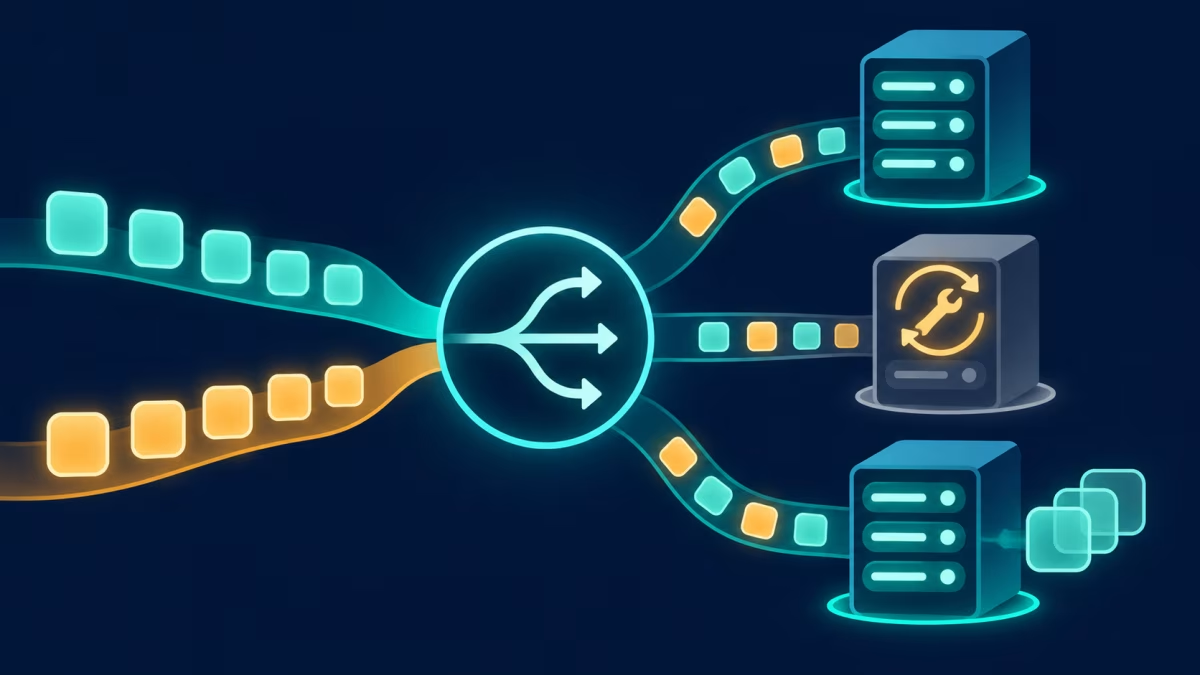
Nota keluaran rasmi menyenaraikan kawalan aliran yang mengambil kira keutamaan dan keadilan antara beban kerja. Ketika kapasiti tertekan, sistem menyediakan mekanisme untuk mengehadkan penerimaan permintaan secara terkawal. Matlamatnya ialah membolehkan permintaan yang memerlukan respons pantas berkongsi infrastruktur dengan aktiviti ejen yang datang secara mendadak.
Sebagai gambaran editorial, bayangkan satu aplikasi mempunyai ruang sembang pelanggan dan tugas automatik membaca dokumen. Pasukan operasi boleh menilai dasar yang melindungi masa respons sembang sambil memberikan ruang munasabah kepada kerja dokumen. Contoh ini menerangkan tujuan kawalan tersebut; ia bukan laporan pelaksanaan sebenar di Malaysia.
Sumber: llm-d v1.0.0 Release.
Naik taraf dan perbualan berulang turut diberi perhatian
Versi 1.0 membawa sokongan ketersediaan tinggi pada penghala, komponen siap sedia dan kemas kini berperingkat. Nota projek turut menerangkan DisaggregatedSet, yang mengurus replika pemprosesan arahan dan penjanaan jawapan sebagai satu unit logik untuk menyelaraskan naik taraf. API konfigurasi penghala pula mencapai versi v1.
Bagi ejen AI, penghalaan berasaskan sesi membantu mengekalkan hubungan antara perbualan berulang dengan konteks yang telah dicache. IBM menerangkan bahawa penggunaan semula konteks boleh mengurangkan pengiraan berulang. Ciri ini berkaitan dengan cara permintaan dihantar dan diproses, bukannya bukti bahawa jawapan model menjadi lebih tepat.
Sumber: llm-d 1.0 hardens open-source AI inference for day 2 production operations; llm-d v1.0.0 Release.
Baca dakwaan penjimatan bersama keadaan ujiannya
Dalam pengumumannya, IBM memetik demonstrasi beban kerja ejen yang menghasilkan anggaran kos setiap token lima hingga sepuluh kali lebih rendah berbanding harga API komersial setara. Perbandingan itu menggunakan kadar sewaan awan ketika ujian dan menunjukkan penjimatan terbesar pada corak trafik yang banyak menggunakan input.
Angka tersebut ialah hasil demonstrasi yang dilaporkan vendor, bukannya jaminan untuk semua aplikasi. Ia juga tidak membuktikan bahawa organisasi Malaysia akan memperoleh penjimatan sama. Pembaca perlu membezakan keputusan bagi konfigurasi dan beban kerja tertentu daripada jumlah kos mengendalikan perkhidmatan sendiri.
Sumber: llm-d 1.0 Advances Open, Cost-Efficient AI Inference for Production Scale.
Cadangan editorial: bina ujian kecil yang menyerupai kerja sebenar
Untuk pasukan Malaysia yang sedang menilai infrastruktur AI sendiri, cadangan kami ialah bermula dengan satu perkhidmatan percubaan dan data rekaan. Gunakan pertanyaan Bahasa Malaysia serta bahasa Inggeris yang mewakili kegunaan sasaran. Sertakan arahan pendek, dokumen panjang dan perbualan beberapa pusingan supaya ujian tidak hanya mencerminkan satu jenis permintaan.
Tetapkan ukuran sebelum mengubah konfigurasi: masa menunggu jawapan pertama, tempoh jawapan lengkap, permintaan gagal dan jumlah kerja yang selesai. Jalankan trafik sembang bersama kerja dokumen, kemudian bandingkan kesannya apabila dasar keutamaan diubah. Rekod juga permintaan yang ditolak supaya respons pantas tidak dinilai secara berasingan daripada pengguna yang gagal dilayan.
Uji satu penyelenggaraan terancang dan catat gangguan yang benar-benar berlaku. Dalam anggaran kos, masukkan masa kakitangan, pemantauan dan kapasiti simpanan. Bagi pelajar atau pencari kerja, dokumentasikan andaian, konfigurasi dan kelemahan eksperimen sebagai portfolio. Laporan yang menerangkan sebab sesuatu keputusan berlaku lebih berguna daripada sekadar tangkap layar sistem berjaya dipasang.
Rujukan
- llm-d 1.0 hardens open-source AI inference for day 2 production operations — 2026-10-20
- llm-d v1.0.0 Release — 2026-10-20
- llm-d 1.0 Advances Open, Cost-Efficient AI Inference for Production Scale — 2026-10-20
Disediakan secara automatik dengan bantuan AI berdasarkan sumber yang dipautkan. Semakan sumber: 2026-11-03. Gambar utama ialah ilustrasi janaan AI, bukan foto peristiwa sebenar.
Kumpulan perkongsian peluang kerjaya dalam bidang Teknologi Maklumat(ICT) di Malaysia.